一个团队最后答错了,不代表每个成员都做错了。搜索子智能体可能找到了关键材料,只是协调者没有选中,或者回答者没有用好。如果把同一个“答错了”的分数发给整条链路,搜索过程很难知道下一次该怎么改。
MultiAgent-OPD 分别训练这几类决策:协调者与回答者学习最终结果,搜索子智能体在自己生成的轨迹上接受教师逐 token 的反馈。训练分两阶段,先得到搜索教师,再联合更新团队。
搜索子智能体的反馈问题
我们研究的是 Leader–Searcher–Answerer 结构。Leader 拆分问题,把子任务分发给多个 Searcher;Searcher 检索、读材料、整理报告;Leader 可以再开一轮搜索,最后选出报告交给 Answerer 回答。与固定的“搜一次再回答”相比,这个结构能根据已经找到的证据继续分工。
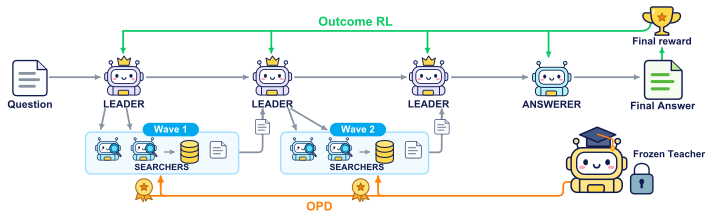
分层流程让一份搜索报告经过选择和推理后才影响答案,最终反馈来得更晚。同一轨迹中的 Searcher 可能拿到一样的优势值,难以区分有效证据与重复检索。
同一问题的轨迹全部答对或全部答错时,结果奖励没有组内差异,相应优势值会消失。但这些轨迹的查询、补查和报告质量仍可能不同,需要能区分搜索过程的反馈。
另一条路是给搜索报告加 LLM Judge。它能提供局部评分,不过质量取决于评审自身的判断,而且一个报告分数仍然覆盖了前面整串动作。MultiAgent-OPD 尝试换一种局部信号:先训练一个会搜索、会总结的教师,让它在学生当前的上下文里评价学生实际生成的 token。
教师模型训练
第一阶段不直接训练复杂团队,而是使用 Searcher–Answerer 串联流程。Searcher 拿到原问题,查询固定检索器并写出报告,Answerer 直接依据报告回答。这样,搜索证据与答案之间的联系更短,比较适合先用正确性奖励学习。
两个角色共享模型参数。训练时每次回答请求生成 5 个候选答案,每个候选有自己的归一化 Exact Match 得分;只要其中至少一个候选正确,这条轨迹的团队结果奖励就为 1。Searcher 主要拿结果奖励,另外获得一小部分行为奖励。
行为项在搜索一次后给出总结时为 0.5,搜索两次及以上再总结时为 1,否则为 0;格式无效的输出总奖励为 −1。正确性仍占主要权重,行为项则鼓励搜索后形成可供回答使用的报告。它并不直接衡量材料是否真正相关,因此不能把行为奖励本身当作证据质量。
这一阶段的策略在串联流程中评测,就是后面的 C-MAS + RL;冻结后作为第二阶段教师。它使用相同的搜索接口,并已做过任务训练,替代了通用模型对报告打分的方式。
学生模型的 On-Policy 蒸馏
学生从原始指令模型初始化,不继承教师权重。Leader 不断更新任务拆分方式,Searcher 接到的子问题和材料也会变。因此,监督需要覆盖学生当前访问的状态,固定的教师轨迹不足以表达这种变化。
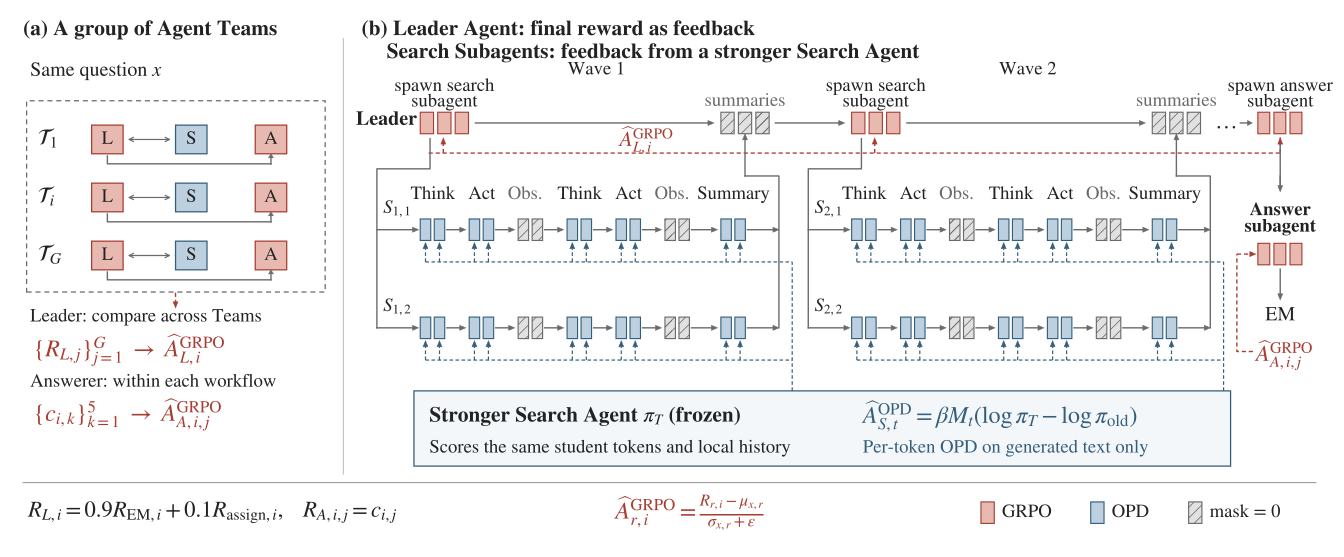
学生先生成团队搜索轨迹,教师再读取相同的角色提示、子任务、检索材料和生成前缀,计算学生 token 的概率。教师只评分这些已有输出,不另走自己的路径,也不生成供逐字模仿的标准报告。
on-policy distillation 的样本来自当前学生,教师在学生到达的历史上给出偏好。Leader 改变分工,教师就评新的子任务历史。两阶段的 Searcher 都接收问题并返回报告,因此可以沿用教师的搜索接口。
Token 级优势计算
蒸馏目标采用学生到教师方向的反向 KL。下面的 mask 只保留 Searcher 生成的 token;检索器返回的材料和 padding 都被排除。
在实际 PPO 更新里,学生采样策略记作 π_old。每个搜索 token 的优势,使用教师与采样策略对同一个 token 的 log-probability 差值,再乘以系数 β。论文中 β 为 0.01。
教师认为这个 token 比采样策略认为的更合适时,优势为正,更新会倾向于提高它的概率;反之则降低。这个信号可以覆盖查询生成、过程中的文字和最终总结,不只给整份报告一个统一分数。即使最终答案错误,或者组内结果奖励全部相同,搜索 token 仍可能获得非零反馈。
这个优势表示教师在局部历史下对 token 的偏好,并不估计 token 对最终答案的因果贡献。教师也有局限,OPD 提供了更细的过程监督,尚未解决完整的因果信用分配。
Leader 与 Answerer 的奖励
Leader 的主要目标仍然是团队答对,另加一个有上限的搜索活动奖励。这里统计的是包含至少一个 Searcher 搜索动作的环境步数,计数超过 6 后不再增加奖励,不是简单地给每个搜索子智能体发一份奖励。
Answerer 按候选正确性学习。Leader 在同一问题的团队轨迹间归一化奖励,Answerer 在各自 workflow 内比较候选,两种组相对训练使用不同范围。
最后把各角色的优势放回各自生成的 token,用 PPO clipped objective 和 entropy bonus 一起更新共享学生。Leader 与 Answerer 的奖励还包含系数为 10⁻³、指向教师的 KL 惩罚;Searcher 已经用 OPD 替换结果优势,不再额外叠加同样的 KL policy loss。
推理时只保留学生,三个角色通过不同提示调用同一个模型,教师不参与运行。共享参数也意味着一个角色的更新会影响另外两个角色:角色分工并没有把模型隔离成三份独立参数。
评测设置
实验统一使用 Qwen3-4B-Instruct-2507,接同一个 E5 检索器,每条查询返回 3 段材料。训练数据来自 79,168 条 NQ 和 90,447 条 HotpotQA。训练使用 veRL 与 SGLang,batch size 为 32,每个问题采样 5 条轨迹,学习率为 10⁻⁶,进行 5 次 PPO minibatch 更新。
串联流程允许 5 个环境步,分层流程允许 12 个环境步,后者最多有 5 轮 Leader 分派。比较它们时,需要把结构、训练和运行预算一起看。Prompted Critic 与 MultiAgent-OPD 则使用同样的分层结构和 Leader 目标,主要差别是 Searcher 的学习信号。
测试包含固定的 5,000 个问题,覆盖 NQ、TriviaQA、PopQA、HotpotQA、2Wiki、MuSiQue 和 Bamboogle。每个问题独立运行 4 次,评测时每个回答请求只生成 1 个候选,不能和训练时的 5 候选混用。
- avg@4 是四次运行得分的平均,估计单次尝试的正确率。
- pass@4 是四次中至少答对一次的问题比例,表示覆盖上界,没有附带一个能挑中正确答案的选择器。
- Macro 对七个数据集等权平均,不是把全部问题混在一起算一个总体分数。
最终答案用归一化 Exact Match 判分,缺失或格式错误的答案都算错,不丢弃失败轨迹。去重检查排除了跨训练、开发和测试的规范化同题,但没有证明不存在改写重复或预训练污染。
主要结果
| 系统 | Macro avg@4 | Macro pass@4 |
|---|---|---|
| C-MAS base | 25.09% | 34.02% |
| C-MAS + RL | 36.07% | 45.97% |
| H-MAS base | 28.60% | 39.32% |
| Prompted Critic | 34.62% | 45.96% |
| MultiAgent-OPD | 38.68% | 48.73% |
未训练时,H-MAS 优于 C-MAS;训练后,C-MAS + RL 又优于 Prompted Critic。分层架构的优势没有自动转化为更高的训练分数,Searcher 的监督方式仍会影响结果。
MultiAgent-OPD 的 Macro avg@4 比 Prompted Critic 高 4.06 个百分点,比 C-MAS + RL 高 2.61 个百分点。相应的配对 95% 区间分别为 [2.98, 5.12] 和 [1.49, 3.73]。这些区间来自对固定模型的测试问题重采样,不是跨多次独立训练得到的稳定性结论。
MultiAgent-OPD 在七个数据集上的 avg@4 都高于 Prompted Critic,但与串联教师相比有升有降。NQ 上 C-MAS + RL 为 43.7%,MultiAgent-OPD 为 42.3%;Bamboogle 从 39.4% 到 46.8%。团队结构的收益随问题类型而异。
论文还统一骨干与协议比较了五个 RL 搜索系统。最接近的 Tree-GRPO 为 37.37% Macro avg@4,MultiAgent-OPD 高 1.31 个百分点。这些外部系统只有聚合分数,没有与主要比较相同的逐题配对区间,因此应把它们作为该协议下的描述性比较。
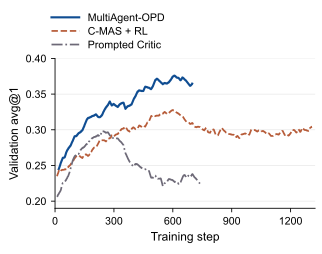
四次都答对的比例,MultiAgent-OPD 为 29.27%,C-MAS + RL 为 27.05%,Prompted Critic 为 23.24%。覆盖与一致性都提高了,但这里仍未提供从多次尝试中选出正确答案的方法。
消融:搜索行为退化
| Searcher 的训练方式 | Macro avg@4 | Macro pass@4 |
|---|---|---|
| 完整方法:任务教师 OPD | 38.68% | 48.73% |
| 换成最终答案奖励的 RL | 17.78% | 22.79% |
| 换成未做任务训练的教师 | 29.50% | 40.86% |
| 去掉 Searcher 的直接监督 | 29.82% | 39.86% |
最终奖励版本的分数下降,同时不再搜索:20,000 条测试 workflow 没有记录到搜索动作,99.51% 却仍有子任务和报告,99.03% 仍生成最终答案。流程可以完成,但证据获取环节已经消失。
开发集在第 300 到 400 步也发生了相同变化:无搜索 workflow 从 0.5% 升到 100%,EM 从 26.0% 降至 21.8%。完成率没有反映检索退化,必须一起检查中间行为。
这一配置下,最终答案奖励没能维持检索。各消融保留了主要设置,但训练 batch 不同,也未单独隔离每项训练选择的作用,结论应限于这组对照。
换成基础教师、保留 OPD 后分数下降,说明教师来源有影响;移除直接监督也下降,说明只训练 Leader 和 Answerer 不够。移除监督并未冻结 Searcher,其他角色仍会更新它们共享的参数。
检索开销
| 系统 | 每 workflow 搜索动作 | 记录的输入 token |
|---|---|---|
| C-MAS + RL | 2.86 | 3,886 |
| Prompted Critic | 4.45 | 6,786 |
| MultiAgent-OPD | 5.39 | 9,172 |
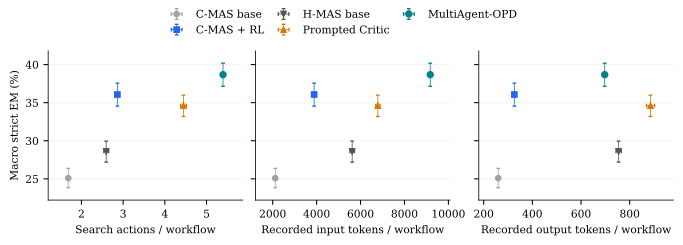
相比 Prompted Critic,搜索动作增加 21.4%,输入 token 增加 35.2%,输出 token 从 885 降到 697。教师不参与推理,但训练后的学生选择了更多检索与输入处理,收益仍伴随额外运行工作量。
Token 记录会重复计算多轮历史,未测端到端延迟、实际费用或总训练成本。串联与分层系统的步数上限也不同,这张图用于观察正确率及相应工作量,不构成等算力条件下的效率比较。
论文还估计了格式失败的影响:假设 Prompted Critic 的全部格式失败都能修成正确答案,MultiAgent-OPD 剩余差距为 0.33 个百分点,区间跨零。这是假设的完美修复上界,并非实际收益;总分差距中包含格式完成因素,不能全部归于证据推理。
两跳问答示例
用“某部电影的导演出生在哪里”作接口示例:Leader 可以先让 Searcher 查导演,再根据报告分派出生地查询;已知部分信息时,也可以直接安排具体补查。后一轮任务取决于前一轮证据,这个示例不是新增实验。
Searcher 与教师看到相同的子问题和局部历史,不使用事后正确答案。如果上游查错人,教师仍只在学生实际访问的历史里评分,未必能纠正分工。Leader 的任务组织、Answerer 的证据使用,仍需最终结果奖励来训练。
若 Searcher 找对了导演,Leader 却没选这份报告,团队奖励仍可能为零。局部教师反馈在这种失败中仍可提供不同信号,让搜索过程继续学习,同时保留最终正确性这一团队目标。
训练批次中的分组
训练配置里既有每题 5 条团队轨迹,也有每个回答请求 5 个候选。两层采样承担不同工作。前者帮助比较同一问题下不同的协作路径,后者帮助比较给定报告之后的不同答案。把候选答案的得分直接在所有团队之间混合归一化,会改变论文所定义的 Answerer 学习问题。
Searcher 使用局部历史下的教师与采样策略比值,不沿用上述结果优势。不能将整条轨迹压成一个分数再复制给所有搜索 token。训练数据需保留角色、workflow、候选和局部调用的归属,才能逐 token 分配优势。
冻结教师提供目标偏好,旧学生生成样本,更新中的学生计算 PPO 概率比。教师不变,学生访问的状态仍在变化。在策略蒸馏需要随这些新状态评分,缓存一份静态教师轨迹会改变训练流程。
格式完成与证据使用
主要评测严格提取最后一次 Answerer 输出中的答案标签,没拿到合规答案就记零。这个规则让所有失败都进入分母,但也意味着格式控制是任务分数的一部分。论文另用预先选定的宽松规则重新提取保存的输出,检查是否只是格式差异掩盖了正确内容;它不使用标准答案来挑选候选。
宽松提取不改变主评测,也不将格式失败直接算对。它重新解析已有输出;完美修复上界则假设每个失败都能变成正确答案。实际重提取得分与假设上界需要分别报告。
记录到搜索动作,也要继续检查返回材料是否有用。区分调用、材料、报告和答案,能发现不检索却完成流程的问题;进一步还需检查材料相关性、报告保留的信息,以及 Leader 是否采用报告。工作量只能提供诊断线索。
这些检查能把退化定位到具体接口。平均分停滞,可能来自回答格式、查询生成或信息选择的不同变化。调整奖励前,先确认哪一段行为发生了变化。
轨迹与反馈的对齐
复现时先沿完整轨迹核对角色、局部历史、生成 token 和 mask。Searcher 写的报告接受监督,被 Leader 收到时则是观察,不参与 Leader 生成动作的 loss。教师应看到学生当时的材料和前缀,才能比较同一个决策状态。
第二个检查是归一化范围:Leader 比较团队,Answerer 比较同一 workflow 的候选,Searcher 使用局部教师信号。还要区分学生采样策略、当前更新策略与冻结教师,避免把公式里不同的概率都读成“当前模型的概率”。
任务训练过的教师,为多轮拆解和搜索提供了比最终分数更细的反馈,但仍有教师偏好,也不保证复杂团队总是划算。是否采用这套方法,需要一起检查正确率、检索是否持续、格式完成与运行预算。