大推理模型能把商品问题答得更准,但它们也会想得很久。直播间里,回复生成时话题可能已经过去了。
直播间里的问题通常不长:“还有国补吗”“这两款差在哪”“刚才那个能退吗”。回答时却要同时对齐当前问题、历史对话和商品材料。长推理能够帮助模型梳理这些条件,但数字人无法让观众等十几秒,最终口播也不适合包含模型内部的反复推演。
LiveThinking 先用轻量学生学习商品问答,再通过强化学习减少多余推理。我们为实时电商问答选择合适的推理预算,同时保留事实质量;其他任务是否适合缩短推理,需要另行判断。
正确性与帮助性评估
使用 LLM-as-a-Judge 从两个维度评估回复:
正确性(C)
衡量回复与商品知识的事实一致性:
当且仅当所有陈述都能被文档
帮助性(H)
正确性是基础,但单独优化它可能使模型过度保守,为减少幻觉而只生成极少信息。此类回复虽然事实无误,却无法有效帮助用户,体验较差。
因此引入帮助性作为补充,鼓励模型在准确性与实用性之间取得平衡,提供更丰富、有价值的信息:
有帮助的回复不仅正确回答问题,还应基于文档主动提供相关补充信息,结合对话语境
LLM Judge 校验
接入数据生产和训练前,我们用人工标注校准 Judge。数百条回复各由两人判断正确性与帮助性,分歧样本剔除,两组正负样本分别平衡到 1:1。调整评审提示词后,正确性集准确率为 83%,帮助性集为 84%。后续使用自动评分时,也要考虑 Judge 自身的可靠程度。
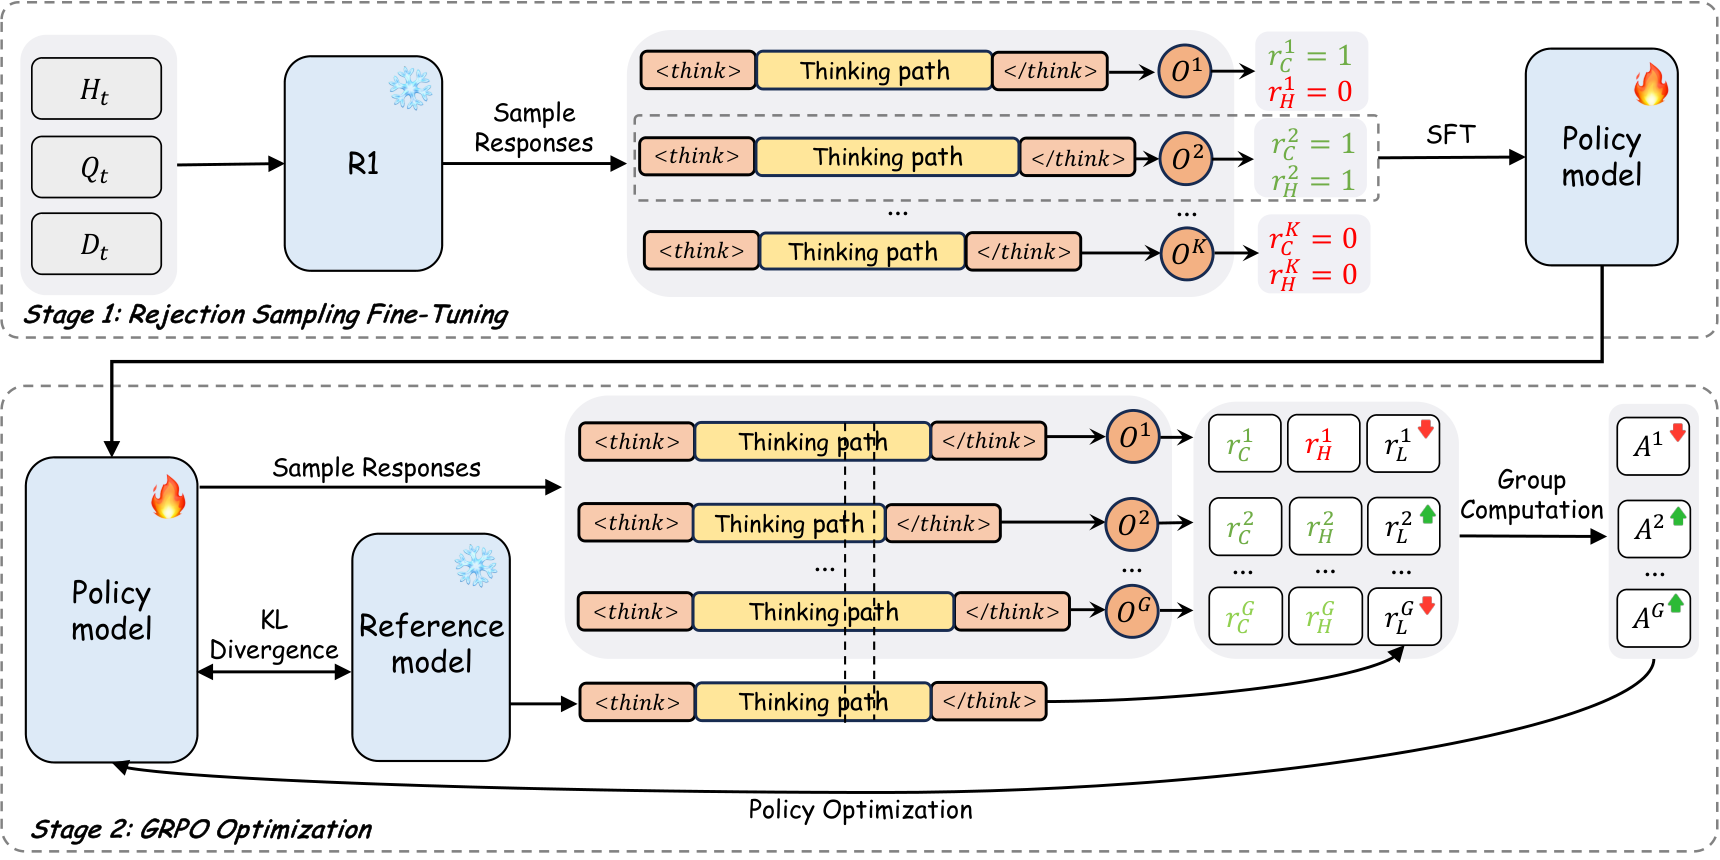
轨迹蒸馏与强化学习
第一阶段通过 RFT 将电商推理能力迁移到轻量模型;第二阶段采用 GRPO 压缩推理路径,在保持回复质量的同时提高效率。
拒绝采样微调
我们采用三个步骤,将 670B 推理 MoE 教师(激活 37B)的能力迁移至轻量学生模型:
教师生成数据
先从无标注的电商语料
LLM Judge 过滤
教师轨迹先交给 DeepSeek-R1 Judge,按前述正确性与帮助性标准过滤,两项都通过才用于学生训练。
对输入
其中
MoE 学生模型微调
学生
主任务损失
输入
推理质量与长度优化
RFT(第 4.1 节)既迁移知识,也继承教师冗长的推理。我们进一步使用强化学习联合优化效率、正确性与帮助性。
强化学习建模
将回复生成建模为马尔可夫决策过程。状态
奖励设计
奖励包含长度、正确性和帮助性三项,分别约束生成开销、商品事实和观众需求。只优化长度可能让模型少说话,却没解决问题,因此需要与质量奖励配合。
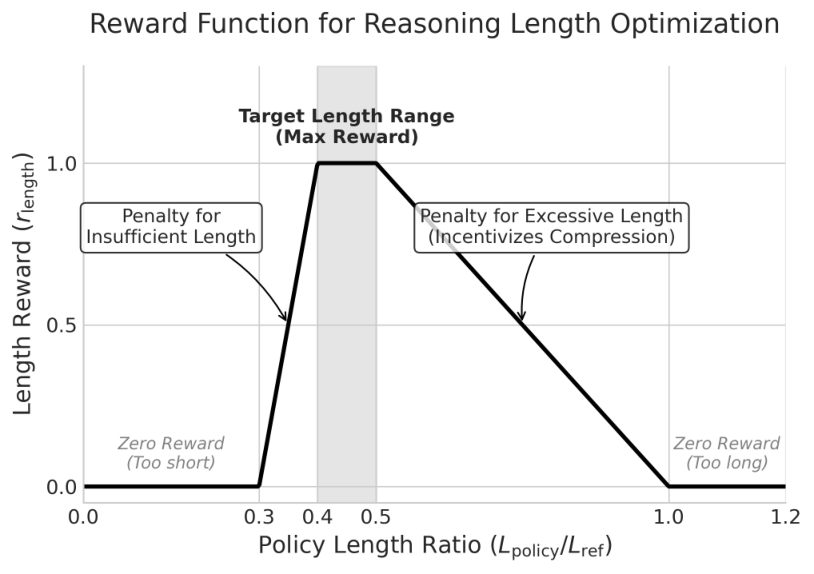
长度奖励
长度奖励
正确性奖励
取值为 1 表示
帮助性奖励
取值为 1 表示
组内优势计算
同一输入采样
直观而言,该机制奖励小批次中优于平均水平的回复,使训练更稳定,对奖励绝对尺度的依赖更小。
策略优化
GRPO 目标最大化经优势与正则项约束的收益:
其中
数据和训练配置
数据集
在两个数据集上评估,每个包含 8000 条训练样本和 400 条测试样本。
Tblive-E-Commerce QA
这组数据来自真实购物直播,每条都带着历史对话、当前弹幕,以及按意图检索出的结构化商品信息。它保留了我们在线上真正要处理的两类麻烦:观众的话有省略和噪声,回答又必须落回给定商品的事实。只看干净、完整的问题,很难把这些问题暴露出来。
MuSiQue
我们也想看方法离开电商数据后会怎样,所以加入公开多跳问答集 MuSiQue。这里一个段落不够回答问题,模型需要把几处事实接起来。我们使用带干扰文档的设置,每题约 10 篇材料,大部分无关;它考察的是如何从噪声里找出并关联有效信息,和直播问答的数据视角正好互补。
评测
不同测试集采用不同协议:Tblive-E-Commerce QA 按第 3.2 节的 Judge 框架评估正确性(C)和帮助性(H);MuSiQue 使用标准的精确匹配率(EM)和 F1 衡量事实准确性。
| 蒸馏超参数 | GRPO 超参数 | ||
|---|---|---|---|
| 参数 | 取值 | 参数 | 取值 |
| 教师模型 | DeepSeek-R1 | 每个输入的 rollout 数( | 8 |
| 基座模型 | Qwen3-30B-A3B | 正确性权重( | 0.4 |
| LLM Judge 模型 | DeepSeek-R1 | 帮助性权重( | 0.3 |
| 采样温度( | 0.7 | 长度权重( | 0.3 |
| 采样数( | 4 | 长度比例上界( | 0.5 |
| 批次大小 | 2 | 长度比例下界( | 0.4 |
| 学习率 | 1.5e-6 | 长度容忍度( | 0.1 |
| 0.01 | 学习率 | 2.5e-6 | |
| 批次大小 | 8 | ||
训练配置
RFT 使用内部基于 Megatron 的框架训练过滤集
结果分析
| 模型 / 阶段 | 正确性 | 帮助性 | 平均输出 tokens |
|---|---|---|---|
| Qwen3-30B-A3B 基座 | 67.3 | 56.5 | 396 |
| + RFT | 81.3 | 77.0 | 353 |
| + RL,未做 RFT | 87.5 | 90.0 | 152 |
| + RFT + RL | 92.3 | 96.8 | 153 |
| DeepSeek-R1 教师 | 89.0 | 75.0 | — |
主要结果
我们选择 Qwen3-30B-A3B + RFT + RL,在这组比较中兼顾回复质量与生成开销。下面分别看最终结果和各阶段的作用。
在 Tblive-E-Commerce QA 上,最终模型的正确性 / 帮助性为 92.3% / 96.8%,教师 DeepSeek-R1 为 89.0% / 75.0%。学生总参数小约 22
MuSiQue 的 EM / F1 为 53.5 / 67.2,教师为 41.2 / 57.0,输出从 807 降至 473 tokens。这说明另一类跨文档问答也有收益,尚不能推断其他领域都有相同改善幅度。
我们还在稠密 8B Llama 基座上做了同样的两阶段训练。DeepSeek-R1-Distilled-Llama-8B 的正确性从 20.8% 到 86.3%,帮助性从 34.5% 到 93.8%,TPR 则从 332 到 152。它说明这组实验的收益不只出现在 MoE 学生上;不同起点的模型仍要分别看,不能直接把两个基座的涨幅放到一起比较。
消融实验
Qwen3-30B-A3B 仅做 RFT,正确性从 67.3% 升到 81.3%,帮助性从 56.5% 升到 77.0%,TPR 只从 396 降到 353:回答改善,较长的教师推理也留下了。仅做 RL 为 87.5% 正确性、90.0% 帮助性和 152 TPR。先 RFT 再 RL,质量达到 92.3% / 96.8%,因此保留两阶段方案:先学习回答,再通过学生自身采样优化质量与开销。
拒绝采样微调效果
| 方法 | 正确性 | 帮助性 |
|---|---|---|
| SFT | 81.0 | 72.0 |
| RFT | 81.3 | 77.0 |
同一教师不经过滤的普通 SFT,是 RFT 的对照。两者正确性差别不大,RFT 帮助性高 5.0 个百分点。可能因为商品事实较明确,直接模仿就能学到;而不同教师轨迹在表达清楚、理解需求上更不稳定,Judge 过滤筛选了这部分差异。因此,数据生产既要生成轨迹,也要判断哪些适合训练。
目标推理长度
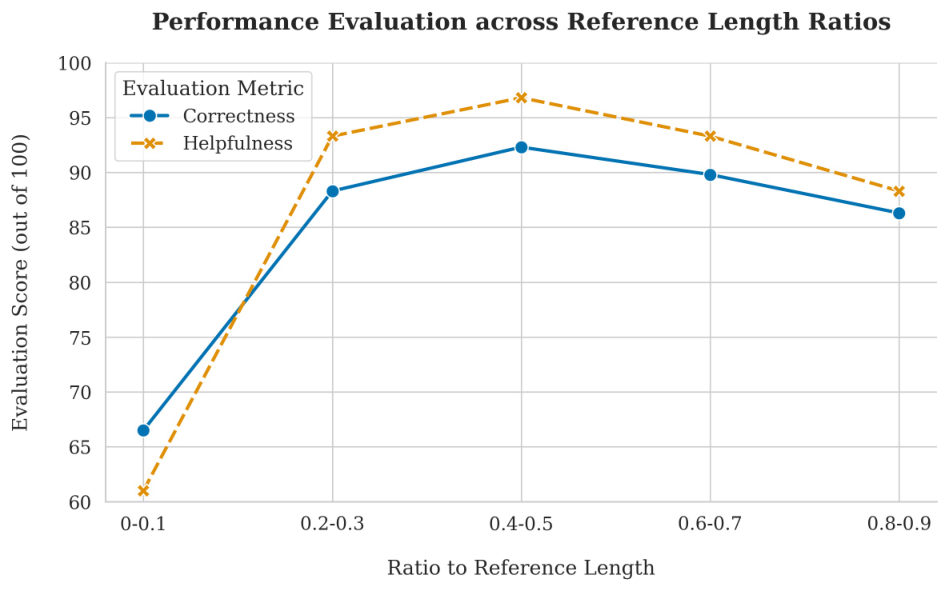
我们调整
奖励函数消融
| 奖励 | 正确性 | 帮助性 | TPR |
|---|---|---|---|
| 91.5 | 95.0 | 349 | |
| 87.3 | 72.3 | 145 | |
| 79.3 | 96.8 | 152 | |
| 完整奖励 | 92.3 | 96.8 | 153 |
分别移除
加入长度奖励后,生成量下降,正确性和帮助性也有改善。移除帮助性、只用
MoE 模型选型
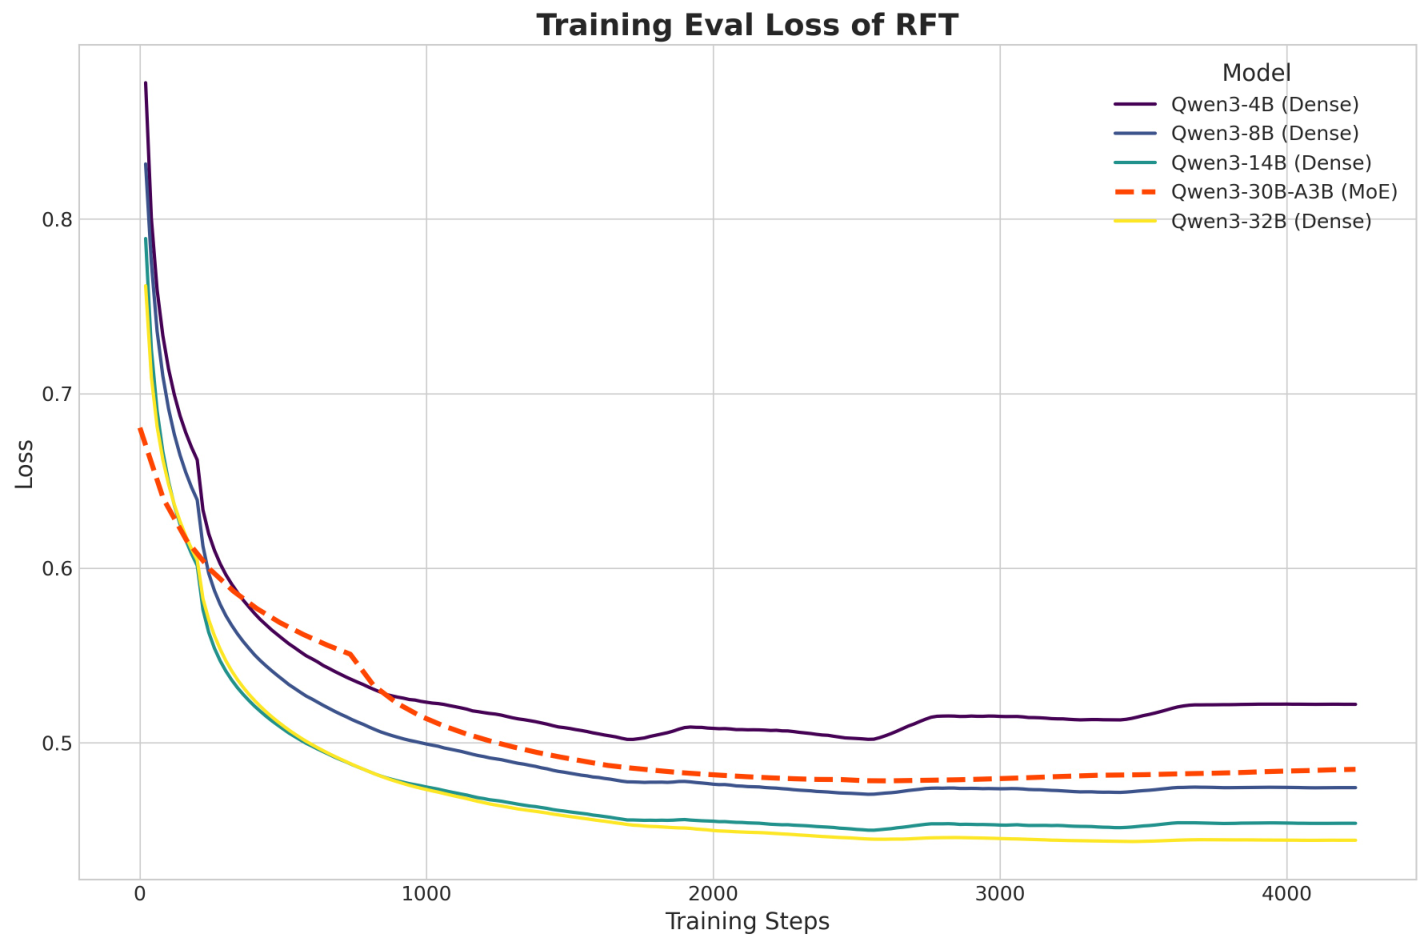
我们比较了 MoE 与 4B–32B 稠密模型。Qwen3-30B-A3B 总参数为 30B、激活 3B,在该任务上接近约 7.5B 的较大稠密模型,推理成本较低,也优于更小的稠密模型。因此将它作为后续部署优化的起点;这项结构选择对应当前任务与开销要求。
案例:商品材料不足时的回答
观众要“一款单冷的空调”,材料里的三款却都是冷暖型。模型应识别商品不匹配,不能将其中一款说成单冷,也不能按常识补出未提供的库存。
原文对比了 RFT 与 LiveThinking 的推理和最终回答。两者都识别到了商品不匹配,区别更多体现在推理过程是否反复,以及最终回答是否清楚说明了依据。RFT 的长轨迹会在“没有匹配商品”“如何委婉回复”“是否转客服”之间多次重复;压缩后的轨迹较快确认三款商品的类型,再围绕无法满足需求组织回复。
这个案例中,重复检查和措辞推敲可以压缩,商品是否符合条件仍需判断。先核对需求与材料,再决定能回答什么,是压缩后也要保留的步骤。
最终回复仍需核验。推理已识别材料不足,回答也可能补入无依据建议;定制、非标型号或其他库存都需要额外证据。长度与奖励优化会影响这种倾向,但不替代对最终声明的检查。
在回放中,我们会把问题、检索材料、内部推理和最终回复放在一起看。若最终回答过于保守,就检查帮助性是否被奖励;若回答很热情却混入猜测,就检查事实约束;若质量没有变化但思维链更长,就检查长度奖励与停止策略。这样才能把一次失败归到可调整的环节,而不是笼统地说“模型能力不够”。
训练流程
教师针对同一输入生成多条轨迹后,先检查最终回答有无材料依据,再检查是否有帮助,合格后才进入 RFT。原始请求保留了问题、历史对话和商品材料,便于核对。筛选能减少学生模仿教师编造、敷衍和重复推理的问题。
RFT 与普通 SFT 都用监督学习,区别是哪些样本进入训练。同一问题有合格轨迹才保留,全部不合格则舍弃。拒绝采样减少了数据量,同时改善示范的可靠性;Judge 因此需要校准,尤其不能把较长的回答直接当作更有帮助。
RL 中,学生根据自己的输出接收反馈。只奖励事实一致,模型可能用空泛、保守的回复规避错误;只奖励长度,可能在条件未核对完时结束。因此,正确性、帮助性与长度共同约束这两类行为。
长度奖励设置可接受区间,也是出于同样考虑。不同问题需要的计算量不同:简单价格问答可能只需定位一个字段,规格比较则要同时阅读多个商品。参考长度给出的是预算尺度,区间内不必为了少几个 token 继续牺牲信息;越过上界后才强化压缩压力。目标长度实验中,过度压缩会损失质量,因此不能把最短输出的配置直接当成最优配置。
从评测到部署
Tblive-E-Commerce QA 与 MuSiQue 的任务和判分不同,得分不能直接相加。前者评真实电商回答的正确性、帮助性,后者评跨文档推理并报告标准答案匹配指标。公共集改善补充了迁移证据,其他领域的收益仍需测量。
Judge 与人工的一致率也不是模型准确率。它衡量的是自动评测在一批人工标注样本上有多可靠;模型分数则来自另一轮回答评估。把这两个数字分开记录,才能在训练指标异常上涨时检查:是策略真的变好了,还是奖励模型开始偏爱某种容易得分的写法。对生成式奖励而言,审查边界案例与查看总体均分同样必要。
论文还报告了线上业务部署,但线上对照组是此前的 14B Dense 模型,不能把这项 A/B 与离线表格中的 Qwen3 基座消融混为一谈。2025 年 7 月的业务实验观察到转化率和多轮互动指标改善;这些结果同时受旧方案、流量分配和完整服务链路影响。它们支持系统在该场景的实用性,而不是仅凭离线正确性就推导出的业务因果关系。
Token 减少会影响解码开销,完整延迟还包含排队、预填充、检索、语音合成和播出调度。部署需同时测平均值与长尾,并检查商品错误、无依据承诺和拒答是否增加。短推理仍要保证最终口播及时、可靠且有用。